Dev Mobile também faz Observabilidade: O Dia em que Nossos Dashboards Salvaram o Dia
Dev Mobile também faz Observabilidade: O Dia em que Nossos Dashboards Salvaram o Dia
Observabilidade: você ouve a palavra e já pensa em backend, métricas de servidor ou equipes de DevOps, né? Mas a verdade é que quem desenvolve mobile e frontend também precisa estar no meio dessa conversa. Cada camada cuida de uma ponta diferente, mas a responsabilidade sobre a experiência final do usuário é compartilhada.
Eu aprendi a verdadeira importância disso na prática, trabalhando em uma empresa de grande porte. Meu time era responsável por aplicações críticas — como extrato bancário, imposto de renda, relatórios e recebimentos de adquirência —, ou seja, muita superfície de código para garantir que tudo estivesse 100% redondo e funcionando perfeitamente.
Antes da observabilidade de verdade, saber se algo estava errado parecia um exercício de adivinhação. Dependíamos de fatores como:
- Uma queda drástica e inexplicável em eventos de uso;
- O time de QA ou de saúde da release tropeçando em um bug crítico logo no lançamento;
- Ou a sorte (ou o susto) de nós, desenvolvedores, encontrarmos o erro por acaso."
Outro ponto crucial: o time já tinha dashboards e alertas de APM focados no backend, mas eles sofriam de um mal clássico: ruído demais. Apitavam a toda hora por motivos banais, e o resultado foi o pior possível — o time perdeu a confiança nos avisos.
Virou clássico exemplo da história do menino que mentia sobre o lobo. No início, as pessoas se preocupavam e iam checar; com o tempo, virou apenas barulho de fundo e ninguém mais olhava.
E aí veio a minha primeira lição nesse processo: não adianta ter alertas que não alertam nada.
E o time mobile? Zero visibilidade. Naquele momento, a gente nem imaginava o quanto ter dashboards e alertas dedicados traria de tranquilidade e controle para o dia a dia.
Foi durante um PDI que meu líder, na época, levantou essa provocação. Eu vi ali a oportunidade perfeita para mergulhar no assunto, especialmente porque estávamos passando por grandes mudanças no backend que podiam respingar direto no mobile. E o detalhe que elevava o risco: usávamos SDUI (Server-Driven UI), ou seja, um contrato mal ajustado no servidor tinha o poder de causar desde erros não-fatais até falhas críticas que quebravam o app de ponta a ponta.
Com esse cenário na mesa, o nosso primeiro passo foi claro: colocar a mão na massa e montar os primeiros dashboards no Datadog.
Passo 1: A Criação dos Dashboards (e o Choque de Realidade)
A Inteligência Artificial foi uma aliada gigantesca nesse processo de aprendizado. O próprio Datadog tem recursos e assistentes de IA excelentes, o que facilitou demais o planejamento e a criação inicial. Outra estratégia que me ajudou muito foi explorar dashboards existentes de outros times para me inspirar e tirar insights de como as nossas visualizações poderiam ser construídas.
E qual foi o meu maior aprendizado nessa fase?
Não adianta nada querer montar o dashboard mais lindo do mundo se você não parar antes para estruturar bons logs.
O log emitido pelo aplicativo é a nossa verdadeira fonte de ouro. É ele que carrega as respostas para os mistérios de produção, trazendo informações valiosas como:
user_ide a segmentação do usuário;- Qual tela exata disparou o evento;
- O payload e o erro retornado pela API quando a requisição cai no
catch; - A versão do app, sistema operacional e os filtros que o usuário estava aplicando no momento do erro.
Sem um log rico e bem estruturado no cliente, o dashboard fica cego.
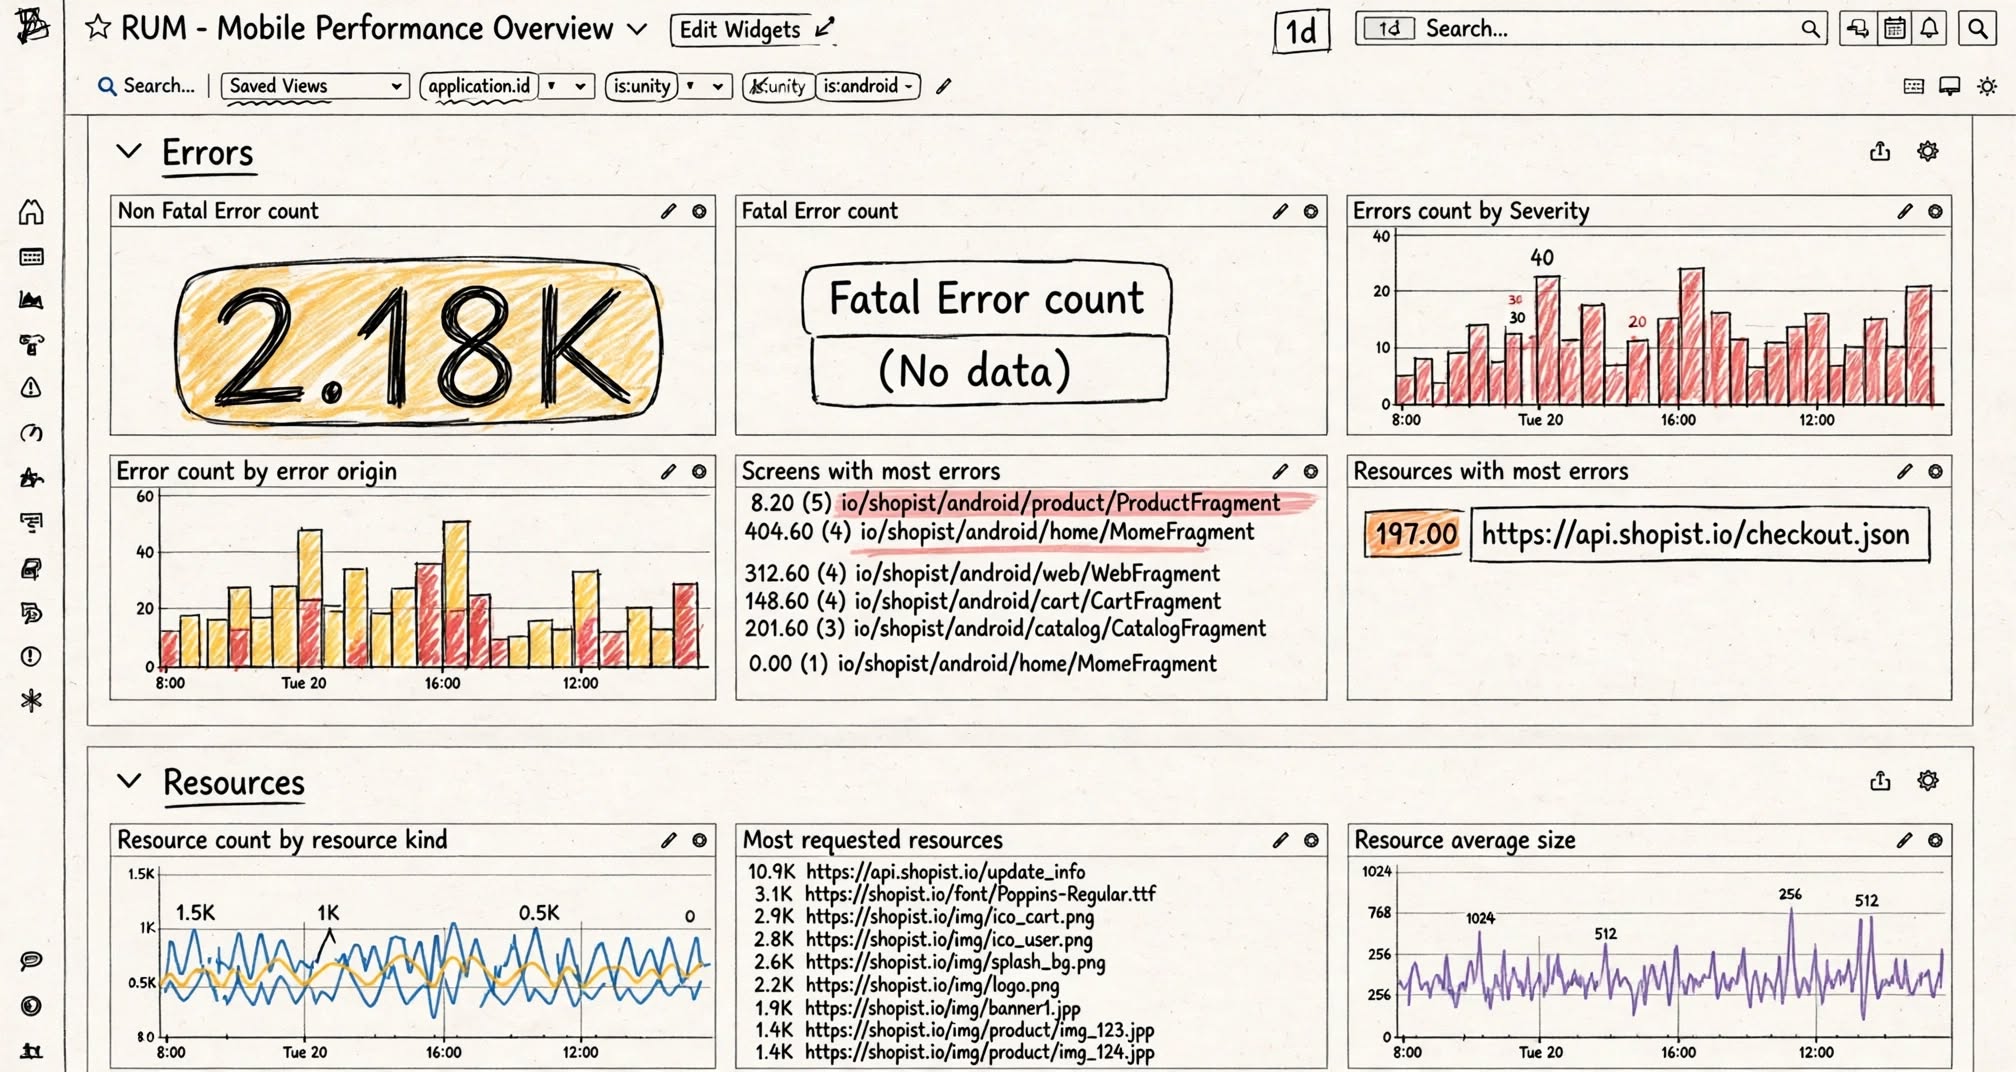
Depois de ajustar os logs, foi só esperar a release ir para produção e acompanhar a dashboard. De cara, a visualização já mostrava a quantidade real de erros e mapeava os principais gargalos. Foi essencial para entender o comportamento normal do app antes de partir para os alertas.
Passo 2: Criar os alertas
Depois de estruturar os logs, o resultado veio rápido. Como o dashboard trazia um card com os principais erros, passei a acompanhar o painel de perto — e foi assim que encontrei o nosso primeiro problema real.
Fiquei super feliz, porque aquilo provou que o trabalho valia a pena e que o monitoramento funcionava de verdade. Naquele momento, o time parou para refletir: como a gente não tinha visto isso antes?
A resposta era simples: alertas cheios de ruído, muitos produtos no ar e grandes mudanças acontecendo ao mesmo tempo. O que a gente precisava era de foco. A ideia era parar de ficar olhando o dashboard o dia todo e deixar que os alertas nos avisassem apenas quando houvesse um problema real. Só que, para isso, eu precisava do fator tempo para calibrar os limiares direito.
E assim foram criados os alertas. Fim da história e vivemos felizes com tudo monitorado? Ainda não.
Passo 3: Calibrar os Alertas
Os alertas do mobile apitavam demaaaaaais. Meu Deus, já não bastava o que a gente já tinha no backend.
Essa etapa me deu muitos aprendizados — frutos de trocas com pessoas do time, apoio de IA e pesquisas em artigos sobre como criar bons alertas:
- 1ª lição (Sensibilidade alta demais): Os alertas eram muito sensíveis. Deixei praticamente sem margem para erros em um produto que atinge mais de meio milhão de acessos diários. Qualquer oscilação mínima já virava um caos.
- 2ª lição (Foco na responsabilidade correta): Eu estava cobrindo erros que eram responsabilidade do backend, pegando falhas que nem eram da nossa BFF (como respostas
401). Removi esses alertas e filtrei o restante para excluir respostas esperadas. - 3ª lição (A estratégia dos submonitores): Conversando em uma daily sobre o incômodo, um desenvolvedor sugeriu aplicar dois sub-monitors: o alerta principal só dispararia se ambas as condições fossem atendidas. Isso eliminou de vez os falsos positivos.
Bônus: A Jornada Continua (De Dev Mobile para o APM)
Spoiler: gostei tanto de observabilidade que me aventurei ainda mais. Passei a estudar sobre APM e traces para entender exatamente onde estava o gargalo quando alguma rota do nosso BFF apresentava problemas.
E, claro, fiquei completamente apaixonada por analisar logs!
Aproveitei esse embalo para puxar uma oportunidade de refatorar e melhorar os alertas do backend do time — claro, com todo o aval e apoio dos desenvolvedores back, para que todo mundo finalmente tivesse paz.
O resultado? Há pouco tempo, ouvi em uma daily que o canal de alertas finalmente está em paz. Não tem preço saber que o monitoramento agora trabalha para a gente, e não o contrário.